
畅联云平台丨04-人脸对齐与ArcFace识别

人脸对齐与 ArcFace 识别:Umeyama、112×112 与余弦阈值
本文讲透一件事:检测到的五点如何变成标准脸,标准脸如何变成可比较的向量,向量如何用余弦相似度判定「是不是同一个人」。对齐核心是 Umeyama 相似变换与 kRef5 模板;识别权重为 w600k_r50.onnx;业务锁定门槛为主角锁定相似度阈值(0.32)。
一、为何必须对齐
识别网络训练时几乎只见过摆正、缩放到固定大小(本项目 112×112)的脸。若把歪头、仰拍、任意裁切直接塞进网络:
- 眼睛可能跑到图像下半部;
- 尺度不一导致纹理频率变化;
- 同一人在特征空间被几何扰动打散。
对齐目标:用检测五点估计变换,把脸搬进训练分布的标准座位。
可以把对齐理解成「证件照规范动作」自动化:眼睛水平、脸居中、尺度统一——不是为了好看,是为了让网络始终在熟悉的几何里工作。
二、 标准五点模板 kRef5
在 112×112 画布上:
- 两眼约在高度 52,水平距约 35.2;
- 鼻尖居中略下 (56, 72);
- 嘴角更靠下 (y≈92),间距约 29.2(小于眼距)。
这是 InsightFace / ArcFace 生态的常用模板。自定义五点却沿用别人的预训练权重,等于把脸摆进网络没见过的座位,分数会系统性异常。
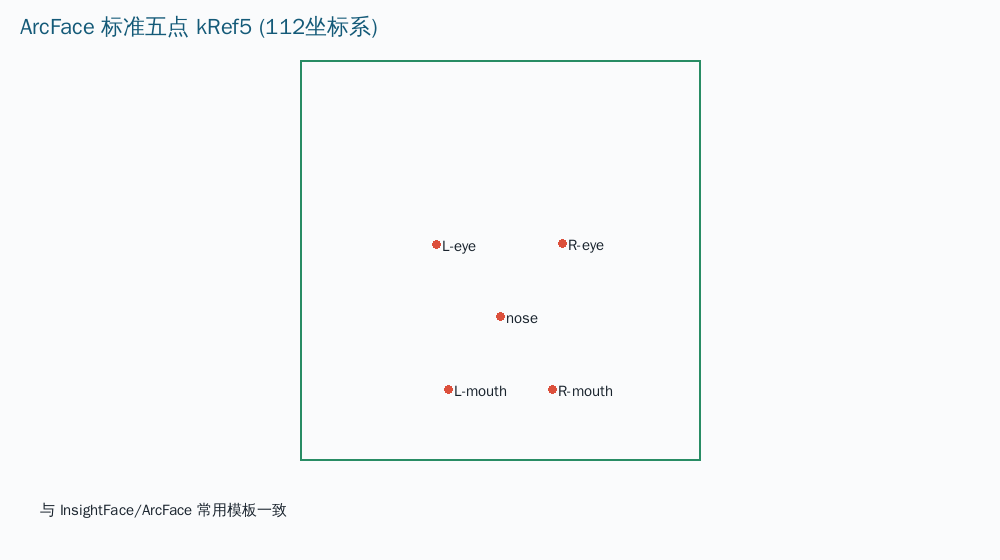
图:112×112 标准五点位置;检测点经相似变换贴合到这些锚点后,再送入 ArcFace。
三、Umeyama:估计 2D 相似变换
相似变换含:旋转 + 统一缩放 + 平移(不含非均匀拉伸)。相似变换估计如下:
映射:
[x’] [ a b tx ] [x]
[y’] = [ -b a ty ] [y]
[1 ] [ 0 0 1 ] [1]
其中尺度 s = hypot(a,b),旋转 θ = atan2(b,a)(按实现约定)。
Umeyama 估计相似变换核心:
static cv::Mat estimate_sim_transform(const std::array<cv::Point2f, 5> &src) {
 double sx = 0, sy = 0, dx = 0, dy = 0;
 for (int i = 0; i < 5; i++) {
 sx += src[i].x; sy += src[i].y;
 dx += kRef5[i][0]; dy += kRef5[i][1];
 }
 sx /= 5; sy /= 5; dx /= 5; dy /= 5;

 double sxx = 0, syy = 0, sxy = 0, syx = 0, var_s = 0;
 for (int i = 0; i < 5; i++) {
 double srcx = src[i].x - sx, srcy = src[i].y - sy;
 double dstx = kRef5[i][0] - dx, dsty = kRef5[i][1] - dy;
 sxx += srcx * dstx; syy += srcy * dsty;
 sxy += srcx * dsty; syx += srcy * dstx;
 var_s += srcx * srcx + srcy * srcy;
 }
 if (var_s < 1e-8) return cv::Mat();
 double a = (sxx + syy) / var_s;
 double b = (sxy - syx) / var_s;
 double tx = dx - a * sx - b * sy;
 double ty = dy + b * sx - a * sy;
 return (cv::Mat_<double>(2, 3) << a, b, tx, -b, a, ty);
}
为何不用自由仿射?
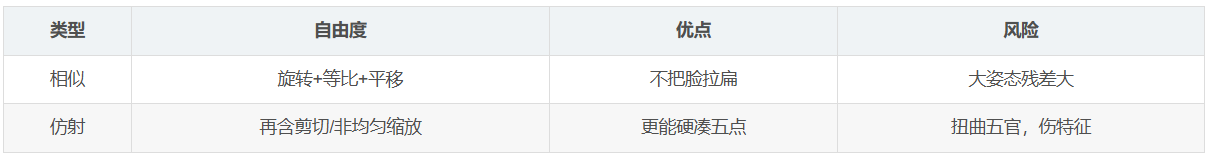
ArcFace 预训练假设偏相似变换;乱升自由度会「对齐看起来贴点、特征却坏」。
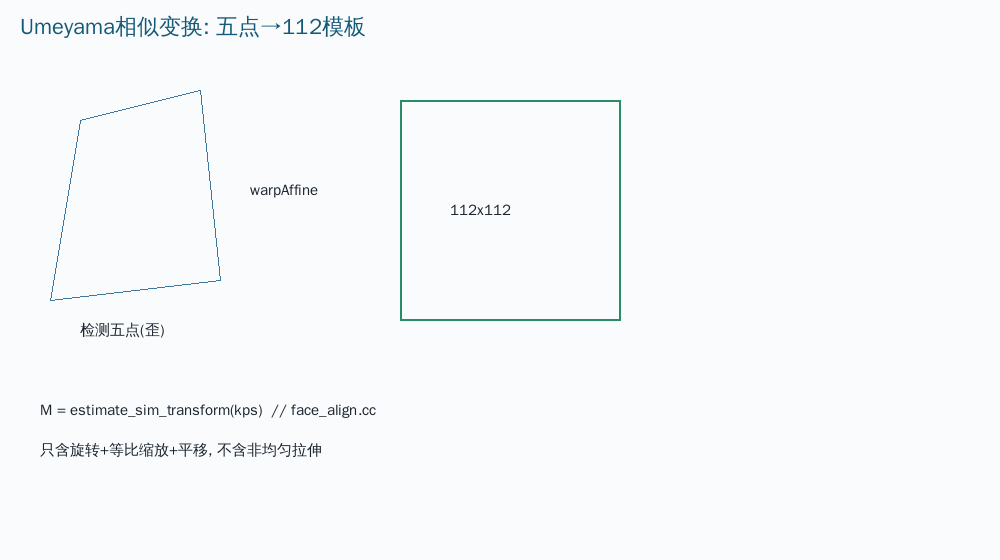
图:检测五点(源)通过 Umeyama 相似变换贴到 kRef5(目标),再 warpAffine 得到 112×112。
四、warpAffine 出图
- 输入是 整帧或足够大的图 + 全图坐标五点(不是只喂紧脸框);矩阵会把五官搬进 112;
- 双线性插值;
- 常数边填充 默认黑边:姿态过大时边角可能黑——这是质量信号。
对齐失败外观: 眼睛不水平、鼻子歪、半张脸黑边、两眼距在 112 图上极小。此类 图 绝不能静默送识别。
数值直觉
假设检测左眼 (200,180)、右眼 (260,182),模板眼距 35.24、检测眼距 ≈60.03:
粗尺度 s ≈ 35.24 / 60.03 ≈ 0.587
再叠加旋转(检测眼连线斜率约 2/60)与平移,使眼落到 (38.3,51.7)、(73.5,51.5)。手算完整 Umeyama 较繁,但可用「对齐后把五点画回 112 图」验收:应几乎压在 kRef5 上。
五、对齐质量门禁
建议显式检查:
- 五点是否都有效、非 NaN;
- var_s < 1e-8 导致 M 空;
- warp 后黑边占比是否过大;
- 112 图上两眼距离是否过小(尺度崩了);
- 重投影误差:把 kps 乘 M 后与 kRef5 的平均距离。
门禁失败应返回明确错误,而不是输出一张扭曲图——后者产生「有相似度、其实是垃圾」的分数,最难排查。
可视化三件套:原图+五点、112 对齐脸、(可选)模板点叠画。
六、ArcFace:脸 → 向量
默认模型:./models/w600k_r50.onnx。
ResNet50 骨干、WebFace600K 一类数据训出的 ArcFace 头;输出通常 512 维(以 ONNX 输出维为准)。流程:
- 对齐得 112×112 BGR;
- 按训练约定转 RGB、归一化、通道优先的张量排布;
- 前向得 feat[D];
- L2 归一化。
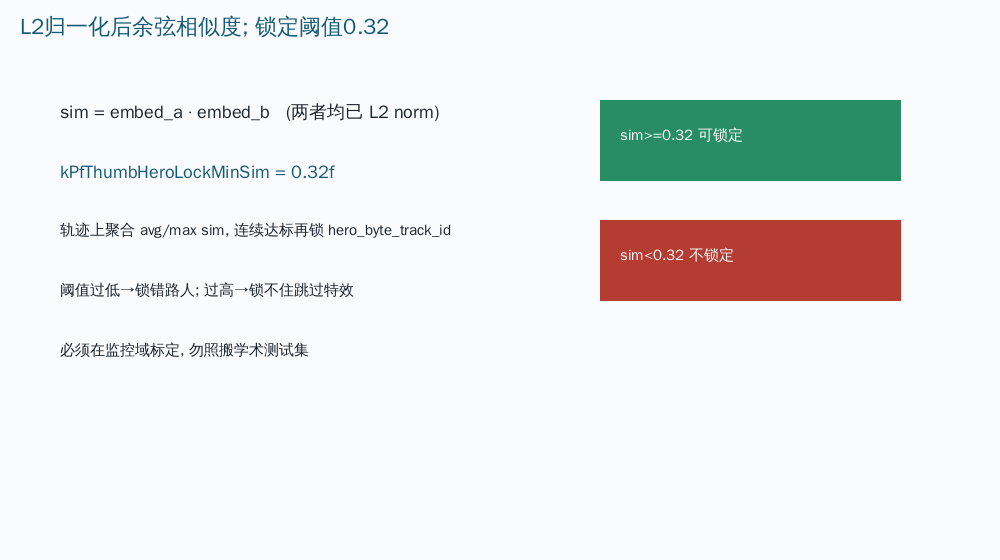
图:L2 归一化后,两向量点积即 cosθ;越接近 1 越像,业务用阈值 T 划分匹配。
公式
sim = cosθ = (a·b) / (|a||b|) = a·b (当 |a|=|b|=1)
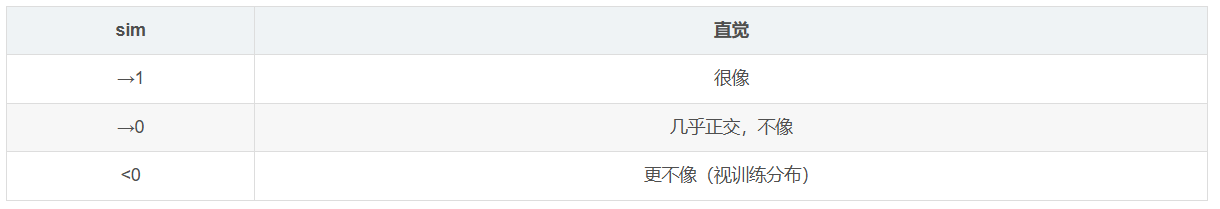
一边归一化、一边不归一化 会让阈值体系整体崩盘。
七、业务阈值:0.32 不是魔法,但是契约
主角锁定相似度阈值(0.32)的用途包括:轨迹平均/最大相似度是否够格参与主角锁定、过低则跳过跟拍等。含义:
- 低于 0.32:默认不认为「够像底图」;
- 达到/超过:进入锁定候选逻辑(通常还要结合多帧、prominence 等,但本篇只讲相似度本身)。
为何不能照搬论文数字?
学术测试集多为近正脸、高清;监控是俯拍、压缩、侧脸、口罩。同一模型在证件照域 0.4 很严,在监控域可能需要 0.32 才锁得住——或反过来。阈值必须在目标域用正负样本对扫出来。
ROC 思维
收集:
- 正对:同一人不同帧 vs 底图;
- 负对:路人 vs 底图。
画分数分布,选误识率可接受的工作点。跟拍场景通常 更不能接受误识(路人锁成主角),故偏严,再用多帧聚合把拒识拉回来。
八、底图质量决定上限
参考脸(thumb)同样:检测 → 对齐 → embedding。烂底图无人能救:
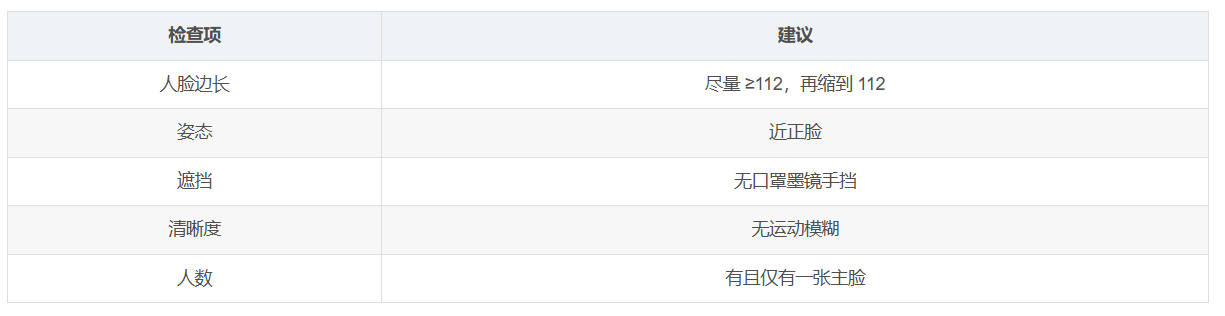
入库门禁失败应拒绝注册。这是性价比最高的质量闸。
九、 侧脸、口罩、墨镜
- 大侧脸:可对齐但对齐后有效纹理少,sim 偏低 → 姿态过滤或等正脸;
- 口罩:鼻嘴区域失效;非口罩模型分数下沉;
- 墨镜:眼点不稳,对齐与识别双杀;
- 逆光剪影:纹理近无,分数无意义。
策略:轨迹保留历史最佳正脸特征;或要求锁定前至少一次高质量正脸。
十、轨迹级聚合 vs 单帧拍板
更稳的做法:
- 每 track 维护最近 N 次有效 sim;
- 用均值或中位数;
- 连续 M 次超过 T 才锁定;
- 锁定后提高变更门槛,避免路人偶发高分抢走。
示例:单帧 0.30 < 0.32,但近 5 帧均值 0.35 且连续 3 帧 >0.30 → 业务可锁。同一模型,决策策略不同,产品表现天差地别。
十一、1:1 与 1:N
本场景多为 1:1(现场脸 vs 用户底图)。扩到 1:N 时:
- 比较次数↑,假阳性期望↑;
- 需开集:最高分不够高则「陌生人」;
- 1:1 的 0.32 不能直接当 1:N 阈值。
十二、归一化细节为何致命
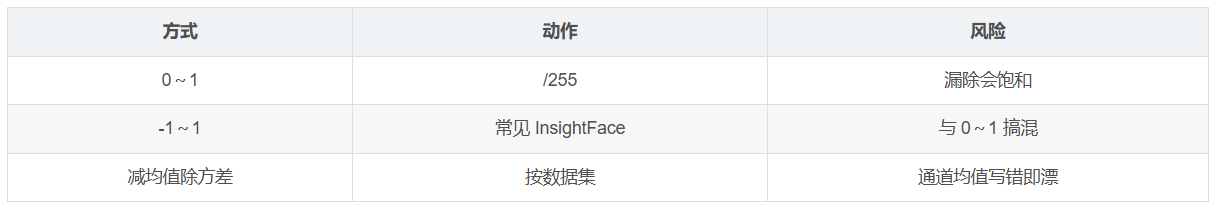
底图与现场必须走同一 embed 函数。几何对齐对了、数值规范化错了,一样认不出。
十三、 端到端分数旅程
- SCRFD 给出全图五点;
- 相似变换估计 + warpAffine → 112×112;
- w600k_r50.onnx 前向 → 512-d,L2 norm;
- 与 thumb embedding 点积得 sim;
- 与主角锁定相似度阈值(0.32)比较,并结合轨迹统计决定是否锁定。
任一步通道反了、未对齐、未归一化,都会表现为「所有人很低」或「所有人很高」。
十四、常见故障对照
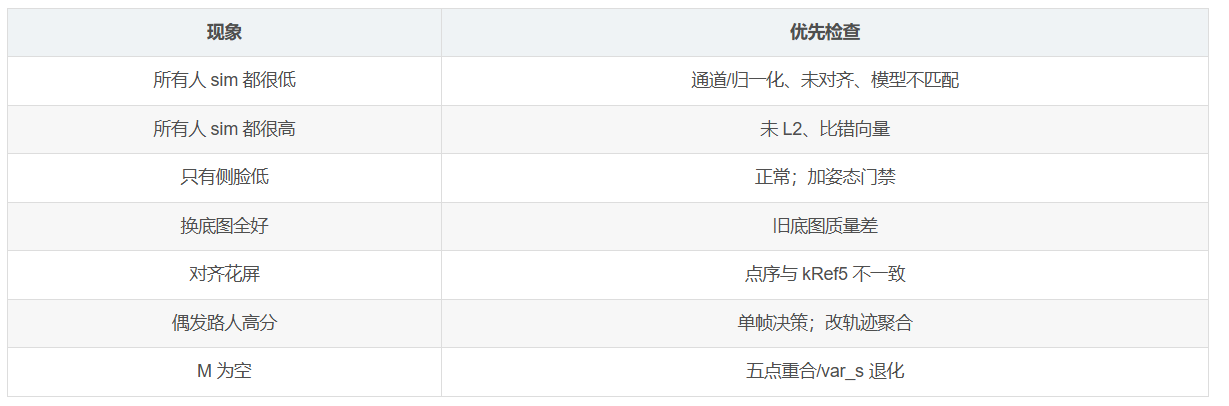
十五、相似变换残差与大姿态
当脸偏航很大,五点无法同时贴近平面模板,Umeyama 仍给出「最小二乘最好」的 M,但残差大,warp 后必扭曲。应用层应:
mean_reproj_err = mean_i || M(src_i) - kRef5_i ||
超过经验像素阈(例如数个像素量级,需按实现标定)→ 本帧不参与锁定投票。
十六、安全与偏见(科普)
embedding 不是原图,仍属生物特征相关数据:控访问、控留存、与用户 ID 映射分离。不同肤色/年龄误差可能不同,评估集应覆盖目标人群。误识业务代价通常高于拒识,阈值策略要反映这一点。
十七、实现检查清单
- 关键点顺序与 kRef5 一致;
- 输出确为 112×112,颜色通道正确;
- 特征 L2 后再点积;
- 底图与现场同一套预处理;
- 阈值来自目标域(本项目契约值 0.32 作起点/默认);
- 对齐失败有错误路径,禁止 silent 黑图提特征;
- 底图入库有质量门禁;
- 线上尽量轨迹聚合。
十八、分数带日常解读(相对本域)
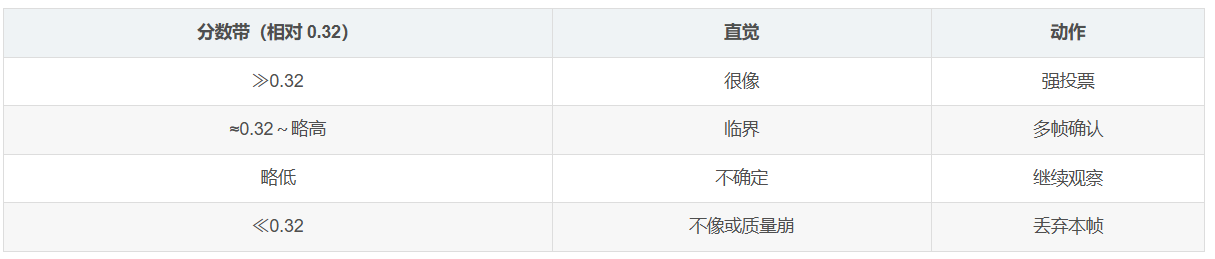
切勿把他域论文阈值直接印刷到产品;换镜头与压缩,分布会移动。
十九、同一人分数为何波动
表情、转头、光照、压缩都会改纹理 。可怕的不是波动,而是用单点极值决策。看分布中心与高质量帧占比:只有偶发尖峰、多数很低 → 怀疑误匹配或门禁失效。
二十、L2 归一化与数值坑
void PersonFocusFaceRecogOrt::l2_normalize(std::vector<float> &feat) {
 double norm = 0;
 for (float v : feat) norm += (double)v * v;
 norm = std::sqrt(norm);
 if (norm > 1e-8) {
 for (float &v : feat) v = (float)(v / norm);
 }
}
数值例子: 未归一化向量若范数约为 12,两向量夹角其实不大,但原始点积可能到几十;另一对范数都很小的噪声向量点积却接近 0。若不归一化就设阈值,等于拿「长度」和「角度」混在一起比,阈值无法跨样本迁移。
若 norm ≤ 1e-8(全零或崩坏输出),函数 不除,特征保持原样——后续点积无意义。应对:检测 embedding 范数,异常则丢弃本帧。
特征比较 在双方已归一化前提下直接累加点积;没有在 compare 里再次归一化。因此必须保证 对齐脸嵌入 / 人脸嵌入 出口已经 L2。若某条 GPU 捷径漏了 normalize,会出现「偶发分数爆炸」。
二十一、 轨迹打分如何吃 0.32
锁定不只看单帧是否 ≥0.32,还会把轨迹统计折成综合分。核心逻辑(人物聚焦模块):
解读:
- 硬门: avg 与 max_sim 同时低于 0.32 → 该轨没有资格;
- 软合成: 更看重 max_sim(0.58),其次高分占比(0.30),均值权最小(0.12)——鼓励「曾经有过清晰正脸」;
- prominence: 人在画面中更大、更居中加分,避免角落路人偶发像而夺锁。
手算例子
轨 A:avg=0.28, max=0.41, hi_ratio=0.3, prom=0.6
硬门:max=0.41≥0.32 → 通过
thumb_core = 0.120.28 + 0.580.41 + 0.300.3 = 0.0336+0.2378+0.09 = 0.3614
score = 0.720.3614 + 0.28*0.6 ≈ 0.260 + 0.168 = 0.428
轨 B:avg=0.35, max=0.36, hi_ratio=0.8, prom=0.3(稳定但峰值一般、不太居中)
thumb_core = 0.120.35 + 0.580.36 + 0.300.8 = 0.042+0.2088+0.24 = 0.4908
score = 0.720.4908 + 0.28*0.3 ≈ 0.353 + 0.084 = 0.437
两轨分数接近时,日志里的 avg/max/n/hi/prom/score 比单看一个 0.32 开关更有信息量。
二十二、 ArcFace 损失直觉(公式级)
训练时类别权重与特征都落在超球面上,logits 用角度:
cos(θ_y) → ArcFace: cos(θ_y + m)
L = -log( e^s·cos(θ_y+m) / (e^s·cos(θ_y+m) + Σ_j≠y e^s·cos(θ_j)) )
- m:角度间隔,迫使同一类更聚、类间更开;
- s:尺度,放大梯度。
推理时你只拿到特征,用余弦比。换模型必须重标定阈值:不同 m/s、不同数据训出的分数分布不可直接共用 0.32。
二十三、 对齐失败的可复现实验
固定一张正脸图,故意搞坏五点:
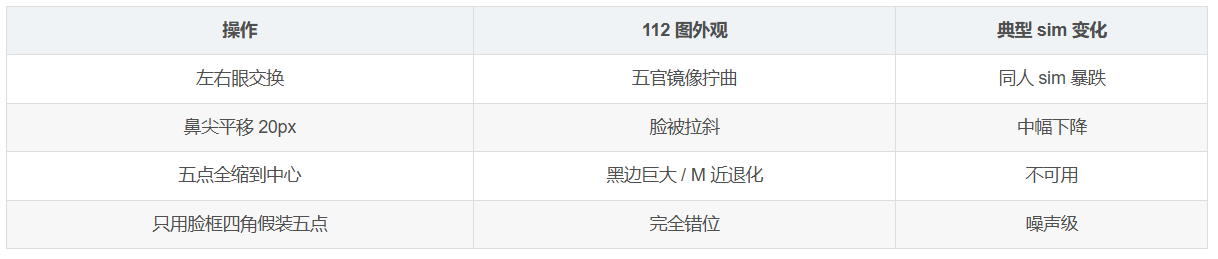
这能快速证明:识别问题优先查几何,再查模型。
二十四、expand-pad 重试与相似度
现场比对偶发失败时,代码会对脸框做约 0.18 比例外扩再 embed(扩大上下文、减轻切下巴)。外扩过大可能引入邻人肩膀纹理,sim 漂移;过小则对齐黑边增多。与检测 ROI「不外扩」不同,这是 识别前对已检脸框 的补偿,两者不要混为一谈。
二十五、余弦与欧氏的换算
双方单位向量时:
||a-b||² = 2 - 2·(a·b) = 2(1 - sim)
故 sim=0.32 对应欧氏距离:
||a-b|| = sqrt(2(1-0.32)) = sqrt(1.36) ≈ 1.166
sim=0.50 → sqrt(1.0)=1.0;sim=0.80 → sqrt(0.4)≈0.632。用哪一种报数都行,但团队内部必须统一,并与主角锁定相似度阈值(0.32)的余弦语义一致。